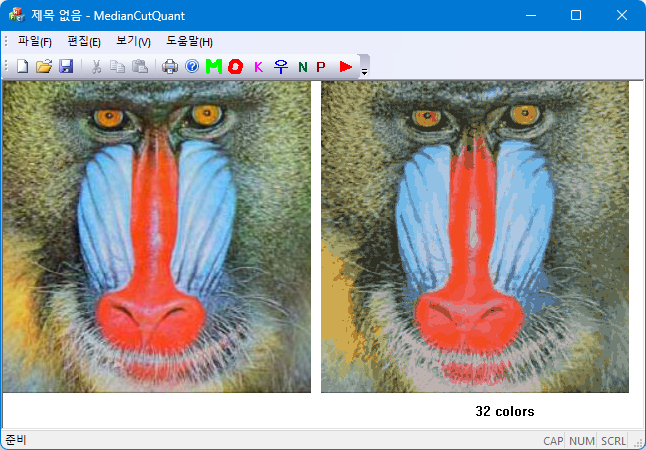
영상처리에서 Color Quantization는 연속적이거나 매우 넓은 색 영역을 표현하는 이미지를, 시각적 손실을 최소화하면서 제한된 개수의 대표 색상으로 매핑하는 이산화 과정이다. 이를 위해 다양한 알고리즘이 개발되어 왔으면, 여기서는 군집화 품질과 디테일 보존 능력이 뛰어나 학술 및 산업계에서 널리 활용되는 PNN(Pairwise Nearest Neighbor) 컬러 양자화 알고리즘을 구현한다. PNN 알고리즘은 통계학의 상향식 계층적 군집화(Agglomerative Hierarchical Clustering)를 컬러 양자화에 적용한 방법이다. 처음부터 목표 클러스터 수 $K$를 정하고 각 데이터를 $K$개의 클러스터 중 하나에 할당하는 K-means와 달리, PNN은 많은 수의 작은 클러스터에서 출발하여 가장 적절한 두 클러스터를 반복적으로 병합한다. 따라서 데이터 공간의 국소적 구조를 단계적으로 통합하면서 최종적으로 원하는 수의 대표 색상을 얻는다.
알고리즘의 기본 과정은 다음과 같다.
-
입력 영상의 고유한 색상 또는 양자화된 컬러 히스토그램 빈(Bin)을 하나의 독립적인 초기 클러스터 $C_i$로 정의
-
현재 활성화된 모든 클러스터 쌍에 대해 병합 비용을 계산하고, 병합에 따른 전체 양자화 오차의 증가가 가장 작은 클러스터 쌍을 탐색
-
선택된 두 클러스터를 하나로 병합한다. 새 클러스터의 대표 색상은 두 클러스터의 픽셀수를 고려한 가중 평균으로 결정되며, 활성 클러스터의 수는 하나 감소한다
-
활성 클러스터의 수가 사용자가 정의한 목표 팔레트 크기 $K$에 도달할 때까지 2~3의 과정을 반복
PNN 알고리즘이 임의의 두 클러스터를 병합할 때, 군집 내 오차 제곱합(SSE, Sum of Squared Errors)의 증가량을 최소화하는 방향으로 결정하는 두 클러스터 $C₁$과 $C₂$를 하나로 병합할 때 발생하는 오차 증가량(병합 비용) $ΔE$는$$\Delta E= \frac{w_1 w_2}{w_1 + w_2 } || \mathbf{\mu}_1 - \mathbf{\mu}_2||^2 $$인데, $\mu_i=(r_i, g_i, b_i)$로 $i$-번째 클러스터의 평균 컬러이고, $w_i$는 그 클러스터에 소속된 픽셀의 수이다. 이 식에서 중요한 점은 단순한 RGB 거리뿐 아니라 각 클러스터에 포함된 픽셀의 수까지 병합 비용에 반영된다는 것이다. 예를 들어 $w_1 \ll w_2$인 경우
$$ \frac{ w_1 w_2}{w_1 + w_2} \approx w_1$$이므로 작은 클러스터와 매우 큰 클러스터의 병합 비용은 대략 작은 클러스터의 크기에 비례한다. 반면 크기가 거의 같은 두 클러스터 $w_1 \approx w_2 \approx w$의 경우에는 $$\frac{w_1 w_2}{w_1+ w_2} \approx \frac{{w}}{2}$$가 된다. 즉, Ward 기준은 색상 중심 사이의 거리와 클러스터의 크기를 동시에 고려하여 병합 여부를 결정한다.
특히 픽셀 수가 적은 색상은 큰 영역을 찾지 하는 색상보다 병합에 따른 전체 SSE 증가에 미치는 영향이 작으므로 비교적 일찍 병합될 수 있다. 그러나 단순히 빈도가 낮다는 이유만으로 가장 큰 배경 클러스터에 흡수되는 것은 아니면, RGB 공간에서 가까운 다른 소규묘 클러스터가 존재한다면 그쪽과 먼저 병합될 수 있다. 이러한 특성 때문에 PNN/Ward 방식은 색상 빈도와 색상 거리를 함께 고려하면서 영상의 색 분포를 점진적으로 압축할 수 있다.
// 실수연산용 RGB color
struct ColorRGB {
    double r, g, b;
    ColorRGB() : r(0), g(0), b(0) {}
    ColorRGB(double rr, double gg, double bb) : r(rr), g(gg), b(bb) {}
};
struct FastCluster {
    ColorRGB	centroid;
    int			weight;
    bool		bActive;
    int			nnIndex;   //nearest neighbor index;
    double		minMergeCost;
    FastCluster()
     : weight(0), bActive(false), nnIndex(-1), minMergeCost(DBL_MAX) { }
};
// Disjoint-Set
struct DisjointSet {
    std::vector<int> parent;
    DisjointSet(int n) {
        parent.resize(n);
        for (int i = 0; i < n; ++i)	parent[i] = i;
    }
    int Find(int i) {
        if (parent[i] == i) return i;
        return parent[i] = Find(parent[i]); // 재귀적으로 루트를 찾으며 경로 압축
    }
    void Union(int dst, int src) {
        dst = Find(dst); src = Find(src);
        if (dst != src) parent[src] = dst;
    }
};

// PNN 병합 비용 계산 함수 (Ward's Method)
inline double calcMergeCost(const FastCluster& c1, const FastCluster& c2) {
    double w1 = (double)c1.weight;
    double w2 = (double)c2.weight;
    double dr = c1.centroid.r - c2.centroid.r;
    double dg = c1.centroid.g - c2.centroid.g;
    double db = c1.centroid.b - c2.centroid.b;
    return (w1 * w2 / (w1 + w2)) * (dr * dr + dg * dg + db * db);
}
// 지정 클러스터의 nearest neighbor를 처음부터 다시 검색
static void updateNearestNeighbor(std::vector<FastCluster>& clusters,
    int index) {
    FastCluster& c = clusters[index];
    c.minMergeCost = DBL_MAX;
    c.nnIndex = -1;

    const int n = (int)clusters.size();
    for (int j = 0; j < n; ++j) {
        if (j == index || !clusters[j].bActive)	continue;
        const double cost = calcMergeCost(c, clusters[j]);
        if (cost < c.minMergeCost) {
            c.minMergeCost = cost;
            c.nnIndex = j;
        }
    }
}
inline int index444(int r, int g, int b) {
    return ((r >> 4) << 8)|((g >> 4) << 4)|((b >> 4));
}
// 알고리즘 main: disjoint-set 사용;
void FastPnnQuantization(const CRaster& raster, int nMaxColors, CRaster& out) {
    if (raster.IsEmpty() || raster.GetBPP() != 24) return;
    CSize sz = raster.GetSize();
    nMaxColors = max(1, nMaxColors);

    // 24비트 색상을 RGB 각각 4비트(총 12비트, 4096가지 색상)로 축소하여
    // 히스토그램 생성(연산속도 증가). 초기 클러스터 개수 압축.
    const int HIST_SIZE = 16 * 16 * 16;
    std::vector<int>		histogram(HIST_SIZE, 0);
    std::vector<ColorRGB>	colorSum(HIST_SIZE, ColorRGB(0,0,0));

    for (int y = 0; y < sz.cy; ++y) {
        BYTE* p = (BYTE*)raster.GetLinePtr(y);
        for (int x = 0; x < sz.cx; ++x, p += 3) {
            int bin = index444(p[2], p[1], p[0]);
            ++histogram[bin];
            colorSum[bin].r += p[2];
            colorSum[bin].g += p[1];
            colorSum[bin].b += p[0];
        }
    }

    std::vector<FastCluster> clusters;
    clusters.reserve(HIST_SIZE);
    std::vector<int> colorMap(HIST_SIZE, -1);

    for (int i = histogram.size(); i-->0;) {
        const int count = histogram[i];
        if (count == 0) continue;
        FastCluster c;
        const double inv_count = 1.0 / (double)count;
        c.centroid = ColorRGB(colorSum[i].r * inv_count,
                              colorSum[i].g * inv_count,
                              colorSum[i].b * inv_count);
        c.weight    = count;
        c.bActive   = true;
        colorMap[i] = clusters.size();
        clusters.push_back(c);
    }
    int nActiveClusters = clusters.size();
    if (nActiveClusters == 0) return;

    // 클러스터가 목표이하면 최종 컬러수 조정;
    if (nMaxColors > nActiveClusters)
        nMaxColors = nActiveClusters;

    // Disjoint-Set 초기화 (초기 고유 색상 수만큼)
    const int nClusters = clusters.size();
    DisjointSet ds(nClusters);
    for (int i = 0; i < nClusters; ++i) {
        clusters[i].minMergeCost = DBL_MAX;
        clusters[i].nnIndex = -1;
    }
    // min(merge cost)cluster 찾기;
    for (int i = 0; i < nClusters; ++i) {
        for (int j = 0; j < i; ++j) {
            double cost = calcMergeCost(clusters[i], clusters[j]);
            if (cost < clusters[i].minMergeCost) {
                clusters[i].minMergeCost = cost;
                clusters[i].nnIndex = j;
            }
            if (cost < clusters[j].minMergeCost) {
                clusters[j].minMergeCost = cost;
                clusters[j].nnIndex = i;
            }
        }
    }

    // Ward merging
    while (nActiveClusters > nMaxColors) {
        double best_cost = DBL_MAX;
        int merge_i = -1;
        // 각 cluster가 가지고 있는 NN 중 global minimum 검색
        for (int i = 0; i < nClusters; ++i) {
            if (!clusters[i].bActive) 	 continue;
            if (clusters[i].nnIndex < 0) continue;

            if (clusters[i].minMergeCost < best_cost) {
                best_cost = clusters[i].minMergeCost;
                merge_i = i;
            }
        }
        if (merge_i < 0) break;
        int merge_j = clusters[merge_i].nnIndex;

        if (merge_j < 0 || merge_j >= nClusters || !clusters[merge_j].bActive) {
            updateNearestNeighbor(clusters, merge_i);
            if (clusters[merge_i].nnIndex < 0) break;
            continue;
        }
        // merge_j -> merge_i
        FastCluster& c1 = clusters[merge_i];
        FastCluster& c2 = clusters[merge_j];
        int w1 = c1.weight;
        int w2 = c2.weight;

        double inv_weight = 1.0 / double(w1 + w2);
        c1.centroid.r = (c1.centroid.r * w1 + c2.centroid.r * w2) * inv_weight;
        c1.centroid.g =	(c1.centroid.g * w1 + c2.centroid.g * w2) * inv_weight;
        c1.centroid.b = (c1.centroid.b * w1 + c2.centroid.b * w2) * inv_weight;
        c1.weight     = w1 + w2;
        c2.bActive    = false;
        ds.Union(merge_i, merge_j);
        --nActiveClusters;

        // nearest-neighbor 정보 갱신
        // merge_i의 centroid가 변경됨: 자신의 NN은 처음부터 다시 계산
        c1.minMergeCost = DBL_MAX;
        c1.nnIndex = -1;
        for (int k = 0; k < nClusters; ++k) {
            if (k == merge_i || !clusters[k].bActive) continue;
            // 기존 NN이 변경/삭제된 cluster였다면 전체 NN 재검색 필요
            if (clusters[k].nnIndex == merge_i || clusters[k].nnIndex == merge_j)
                updateNearestNeighbor(clusters, k);
            // 아니면 기존 NN은 여전히 유효 새로 위치가 변한 merge_i만 추가 비교
            else {
                double cost = calcMergeCost(clusters[k], c1);
                if (cost < clusters[k].minMergeCost) {
                    clusters[k].minMergeCost = cost;
                    clusters[k].nnIndex = merge_i;
                }
            }
            // 동시에 merge_i 자신의 NN 검색
            double cost = calcMergeCost(c1, clusters[k]);
            if (cost < c1.minMergeCost) {
                c1.minMergeCost = cost;
                c1.nnIndex = k;
            }
        }
    }

    // 각 클러스의 대표컬러를 담은 palette 생성;
    std::vector<RGBQUAD> palette;
    palette.reserve(nMaxColors);
    std::vector<int> clusterMap(clusters.size(), -1);

    for (int cid = clusters.size(), pid = 0; cid-->0;) {
        if (!clusters[cid].bActive) continue;
        const ColorRGB& color = clusters[cid].centroid;
        clusterMap[cid] = pid++;
        RGBQUAD q = {0,0,0,0};
        q.rgbRed   = max(0, min(255, int(color.r + 0.5)));
        q.rgbGreen = max(0, min(255, int(color.g + 0.5)));
        q.rgbBlue  = max(0, min(255, int(color.b + 0.5)));
        palette.push_back(q);
    }

    // Disjoint-Set의 Find를 사용하여 컬러 단위 최종 인덱스 맵 생성
    // color444 -> colorMap -> cluster_root -> palette_index;
    std::vector<int> inverseMap(colorMap.size());
    for (int color = colorMap.size(); color-->0; ) {
        int clusterId  = colorMap[color];
        if (clusterId < 0) continue;    //음수 = 한번도 안나타난 컬러;
        inverseMap[color] = clusterMap[ds.Find(clusterId)];
    }
    // 출력용 24-bit 영상 생성;
    out.SetDimensions(sz, 24);
    for (int y = 0, i = 0; y < sz.cy; ++y) {
        BYTE *p = (BYTE *)raster.GetLinePtr(y);
        BYTE *q = (BYTE *)out.GetLinePtr(y);
        for (int x = 0; x < sz.cx; ++x, p += 3) {
            int idx = inverseMap[index444(p[2], p[1], p[0])];
            *q++ = palette[idx].rgbBlue;
            *q++ = palette[idx].rgbGreen;
            *q++ = palette[idx].rgbRed;;
        }
    }
}'Image Recognition' 카테고리의 다른 글
| Neural Network Quantization (0) | 2026.09.20 |
|---|---|
| Wu Color Quantization (0) | 2026.09.19 |
| Marching Squares (0) | 2026.09.16 |
| K-Means Color Quantization (0) | 2026.09.11 |
| Octree Color Quantization 구현 (0) | 2026.09.01 |